Visual AI
11 minutes
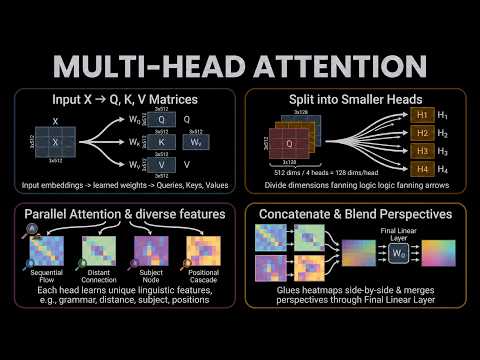
multi-head attention is still the training-time formulation and still correct for short-context and small models — grouping is an inference concession